· 5 min read
একটা project যখন ১০০ জন user নিয়ে Single Server-এ ভালোভাবেই চলছে, তখন হঠাৎ ১০ লাখ বা ১ কোটি user আসতে শুরু করলে কী হবে?
System Design Scaling হলো একটি application-কে ছোট পরিসর থেকে millions of users handle করার উপযোগী করে তোলার প্রক্রিয়া। একটা project যখন ১০০ জন user নিয়ে Single Server-এ ভালোভাবেই চলছে, তখন হঠাৎ ১০ লাখ বা ১ কোটি user আসতে শুরু করলে কী হবে? Server crash করবে, database slow হয়ে যাবে, আর application-এর performance ধরে রাখা কঠিন হয়ে পড়বে। কিন্তু এর সমাধান কি শুধু আরও powerful একটা server কেনা? আসলে বিষয়টা এতটা simple না।
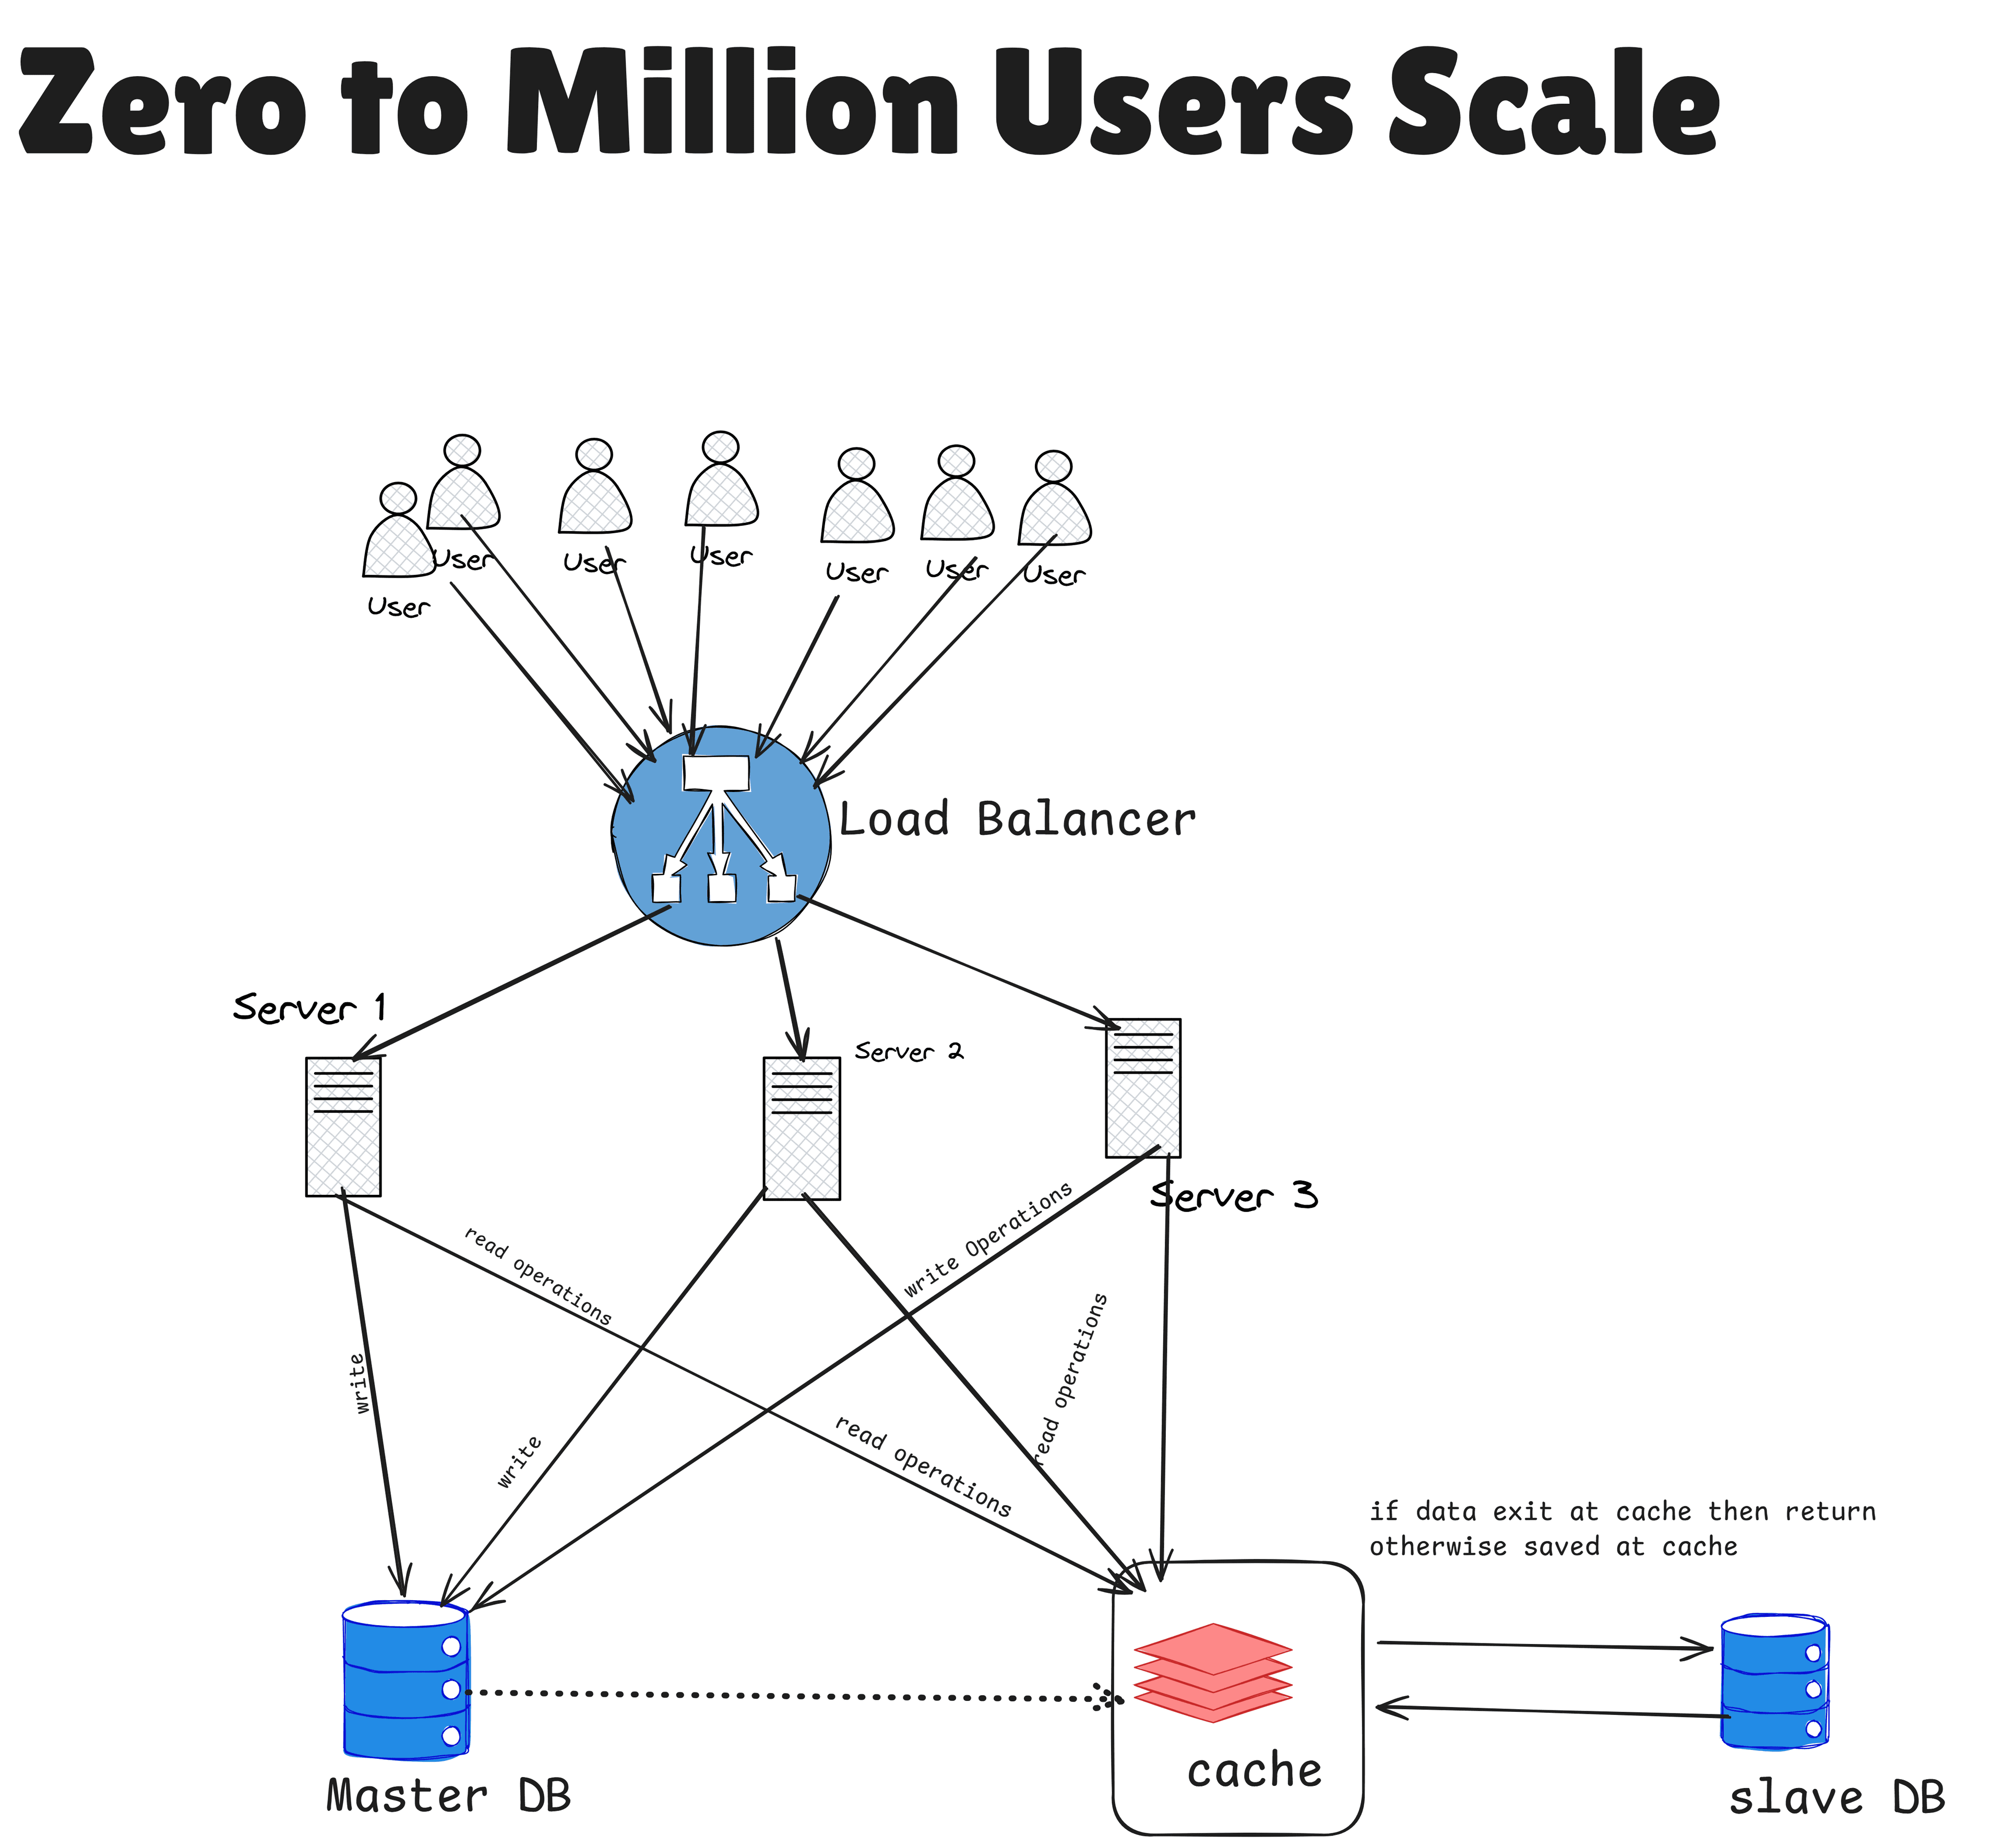
System Design Scaling: ০ থেকে Millions Users
একটা project যখন ১০০ জন user নিয়ে Single Server-এ ভালোভাবেই চলছে, তখন হঠাৎ ১০ লাখ বা ১ কোটি user আসতে শুরু করলে কী হবে?
Server crash করবে, database slow হয়ে যাবে, request timeout হবে। কিন্তু এর সমাধান কি শুধু আরও powerful একটা server কেনা?
আসলে System Design Scaling শুধু server-এর capacity বাড়ানোর বিষয় নয়। এটি এমনভাবে software architecture তৈরি করার প্রক্রিয়া, যাতে application-এর traffic, data এবং user বাড়লেও system নির্ভরযোগ্যভাবে কাজ করতে পারে।
সম্প্রতি Alex Xu-এর System Design Interview – Volume 1 বইয়ের প্রথম Chapter, "Scale From Zero To Millions Of Users" শেষ করলাম।
এই Chapter-এ একটা সাধারণ Single Server Architecture কীভাবে ধাপে ধাপে millions of users handle করার মতো architecture-এ evolve করে, সেটি খুব সুন্দরভাবে ব্যাখ্যা করা হয়েছে।
পুরো journey-টা নিজের বোঝার জন্য সাজিয়ে রাখলাম।
1. Single Server থেকে Database Separation
শুরুতে একটা সাধারণ application-এ Web Server এবং Database একই machine-এ থাকতে পারে।
User request পাঠায়, Web Server সেটি process করে এবং Database থেকে প্রয়োজনীয় data নিয়ে response পাঠায়।
কিন্তু application বড় হতে থাকলে Web Tier এবং Data Tier আলাদা করার প্রয়োজন হয়।
এর ফলে Web Server এবং Database Server আলাদাভাবে scale ও maintain করা যায়।
এখানে Database নির্বাচনও গুরুত্বপূর্ণ:
- RDBMS: Structured data, relational queries এবং ACID properties প্রয়োজন হলে ভালো choice।
- NoSQL: Flexible schema, unstructured data এবং নির্দিষ্ট high-scale use case-এর জন্য উপযোগী।
কোন Database ব্যবহার করব, সেটি নির্ভর করবে application-এর data structure এবং requirements-এর ওপর।
2. Vertical Scaling vs Horizontal Scaling
Server-এর capacity বাড়ানোর দুটি সাধারণ উপায় রয়েছে।
Vertical Scaling (Scale Up):
Existing Server-এর CPU, RAM এবং storage upgrade করা। অর্থাৎ একটি machine-কে আরও powerful করে তোলা।
Horizontal Scaling (Scale Out):
একটি বড় server-এর পরিবর্তে একাধিক server ব্যবহার করা।
Vertical Scaling শুরুতে সহজ মনে হলেও hardware-এর একটা নির্দিষ্ট limit রয়েছে। তাছাড়া একটি server failure হলে পুরো system unavailable হয়ে যেতে পারে।
অন্যদিকে Horizontal Scaling-এ একাধিক server থাকায় traffic distribute করা এবং failover handle করা তুলনামূলক সহজ হয়।
বড় distributed system তৈরি করার ক্ষেত্রে Horizontal Scaling গুরুত্বপূর্ণ একটি building block।
3. Load Balancer এবং Database Replication
একাধিক Web Server তৈরি করার পর নতুন প্রশ্ন আসে—User-এর request কোন server handle করবে?
এখানেই Load Balancer প্রয়োজন হয়।
Load Balancer incoming traffic বিভিন্ন Web Server-এর মধ্যে distribute করে। কোনো একটি server unavailable হলে অন্য server request handle করতে পারে।
Database-এর ক্ষেত্রেও একইভাবে scalability প্রয়োজন।
এজন্য Master-Slave Replication ব্যবহার করা যায়।
- Master Database: সাধারণত write operations handle করে।
- Slave / Read Replicas: Master থেকে data replicate করে read operations handle করে।
এতে read traffic একাধিক database server-এর মধ্যে distribute করা যায় এবং Master-এর ওপর চাপ কমানো সম্ভব হয়।
তবে replication lag এবং read-after-write consistency-এর মতো বিষয়গুলোও মাথায় রাখতে হয়।
4. Cache (Redis) এবং CDN
প্রতিটি user request-এর জন্য বারবার Database query করা efficient নয়।
ধরুন, একটি application-এ হাজার হাজার user একই popular article পড়ছে। প্রতিবার Database থেকে সেই একই data fetch করার প্রয়োজন নেই।
এখানে Cache কাজে আসে।
Redis-এর মতো in-memory Cache ব্যবহার করে frequently accessed বা hot data দ্রুত serve করা যায়।
এর সুবিধা:
- Database-এর ওপর চাপ কমে।
- Response time কমে।
- Frequently accessed data দ্রুত পাওয়া যায়।
অন্যদিকে CDN (Content Delivery Network) static assets যেমন images, CSS এবং JavaScript files user-এর কাছাকাছি Edge Server থেকে deliver করে।
ফলে origin server-এর load এবং network latency দুটোই কমানো সম্ভব হয়।
5. Stateless Web Tier
একাধিক Web Server ব্যবহার করার সময় Session Management একটি গুরুত্বপূর্ণ বিষয় হয়ে দাঁড়ায়।
ধরুন, একজন user প্রথম request পাঠাল Server A-তে। সেখানে তার session data local memory-তে সংরক্ষিত হলো।
পরবর্তী request যদি Server B-তে যায়, তাহলে Server B user-এর session সম্পর্কে কিছুই জানবে না।
এই সমস্যা সমাধানের জন্য Session Data Web Server-এর local memory-তে না রেখে centralized storage-এ রাখা যায়।
যেমন Redis বা অন্য কোনো shared storage।
এভাবে Web Tier Stateless করা সম্ভব হয়।
এর ফলে যেকোনো Web Server যেকোনো request handle করতে পারে এবং Auto Scaling অনেক সহজ হয়।
6. Multi-Data Center এবং Message Queue
User যখন বিভিন্ন দেশ থেকে application ব্যবহার করে, তখন একটি Data Center দিয়ে সব জায়গায় ভালো latency নিশ্চিত করা কঠিন হতে পারে।
এজন্য Multi-Data Center Architecture ব্যবহার করা হয়।
GeoDNS-এর মাধ্যমে user-এর location অনুযায়ী কাছাকাছি Data Center-এ request route করা যায়।
এতে latency কমানো এবং regional availability বাড়ানো সম্ভব।
তবে একাধিক Data Center থাকলে Data Synchronization, Replication এবং Consistency নিয়ে নতুন challenge তৈরি হয়।
অন্যদিকে application-এর কিছু কাজ request-response cycle-এর মধ্যে সম্পন্ন করার প্রয়োজন নেই।
যেমন:
- Email Sending
- Notification Processing
- Image Processing
- Background Jobs
এ ধরনের কাজের জন্য Message Queue ব্যবহার করা যায়।
Producer queue-তে task পাঠায় এবং Consumer পরবর্তীতে সেই task process করে।
এতে Web Server-এর ওপর চাপ কমে এবং application-এর বিভিন্ন component একে অপরের থেকে decoupled থাকে।
7. Logging, Metrics এবং Automation
Application ছোট থাকলে manually log check করে সমস্যা খুঁজে বের করা সম্ভব।
কিন্তু যখন একাধিক server, database এবং service একসঙ্গে কাজ করে, তখন manually সবকিছু monitor করা বাস্তবসম্মত নয়।
এজন্য প্রয়োজন Observability।
এর গুরুত্বপূর্ণ কিছু অংশ:
- Centralized Logging: বিভিন্ন service-এর log এক জায়গায় সংরক্ষণ করা।
- Metrics: CPU, Memory, Request Latency এবং Error Rate monitor করা।
- Monitoring & Alerting: সমস্যা তৈরি হলে দ্রুত জানতে পারা।
- Automation: Repetitive operational tasks স্বয়ংক্রিয় করা।
- CI/CD: Automated testing এবং deployment process তৈরি করা।
Production environment-এ কী ঘটছে, কোথায় bottleneck তৈরি হচ্ছে এবং কেন request fail করছে—এসব বুঝতে Logging ও Metrics অত্যন্ত গুরুত্বপূর্ণ।
8. Database Sharding
একসময় শুধু Read Replicas ব্যবহার করেও Database-এর সব সমস্যা সমাধান করা সম্ভব নাও হতে পারে।
যখন একটি Database-এর storage বা write capacity সীমায় পৌঁছে যায়, তখন Sharding প্রয়োজন হতে পারে।
Database Sharding হলো একটি বড় Database-কে একাধিক ছোট Database বা partition-এ ভাগ করে data distribute করার পদ্ধতি।
প্রতিটি Shard নির্দিষ্ট কিছু data store করে।
যেমন User ID অনুযায়ী data বিভিন্ন Shard-এ distribute করা যেতে পারে।
তবে Sharding করার সঙ্গে কিছু নতুন challenge আসে:
- Resharding: Data নতুন করে বিভিন্ন Shard-এ distribute করা।
- Celebrity Problem: কোনো নির্দিষ্ট user বা entity-কে ঘিরে অস্বাভাবিক বেশি traffic তৈরি হওয়া।
- Hotspot: কিছু নির্দিষ্ট Shard-এ অন্যগুলোর তুলনায় অনেক বেশি load তৈরি হওয়া।
তাই Sharding শুধু Database ভাগ করার বিষয় নয়। সঠিক Sharding Key নির্বাচন এবং Data Distribution Strategy-ও গুরুত্বপূর্ণ।
Real-world Development-এ System Design Scaling
আমরা যখন Next.js, FastAPI, PostgreSQL এবং Redis দিয়ে একটা MVP তৈরি করি, তখন হয়তো Single Server Architecture-ই যথেষ্ট।
কিন্তু user এবং traffic বাড়ার সঙ্গে সঙ্গে Load Balancer, Caching, Stateless Architecture, Message Queue এবং Database Scaling-এর মতো বিষয়গুলো সামনে চলে আসে।
Framework পরিবর্তন করলেই scalability আসে না। বরং application-এর actual bottleneck বুঝে সঠিক architectural decision নেওয়াটাই গুরুত্বপূর্ণ।
একটি ছোট application-এর জন্য শুরুতেই Microservices, Sharding বা Multi-Data Center Architecture তৈরি করার প্রয়োজন নেই।
যে সমস্যা এখনো তৈরি হয়নি, সেটি সমাধান করতে গিয়ে অপ্রয়োজনীয় complexity তৈরি করাও ভালো engineering decision নয়।
Final Thoughts
এই Chapter থেকে আমার সবচেয়ে বড় learning হলো, Scaling কোনো একদিনের কাজ নয়। এটি application-এর প্রয়োজন অনুযায়ী ধাপে ধাপে architecture evolve করার একটি process।
প্রতিটি architectural component কোনো না কোনো নির্দিষ্ট problem solve করে। তাই শুধু technology জানলেই হবে না, কোন পরিস্থিতিতে কেন সেটি ব্যবহার করতে হবে, সেটাও বুঝতে হবে।
একটা প্রশ্ন fellow developers-দের জন্য:
নিজেদের project-এ MVP থেকে Production-এ যাওয়ার সময় প্রথম কোন bottleneck-এর মুখোমুখি হয়েছেন?
- Slow Database Queries?
- Server Overload?
- Session / State Management?
- নাকি অন্য কোনো সমস্যা?
নিজেদের বাস্তব experience কমেন্টে শেয়ার করতে পারেন। অন্যদের experience থেকেও শেখার সুযোগ থাকবে।
#SystemDesign #SoftwareEngineering #BackendDevelopment #Scalability #TechBangla